Meta Prometheus超级集群深... Features
Meta于2026年10月19日公布其位于美国俄亥俄州新奥尔巴尼的Prometheus千兆瓦级AI超级集群详情。这座两年前还服务于常规网络流量的传统数据中心园区,如今已完成第一阶段建设,用于训练Muse系列基础模型(包括Muse Wonder版本),并规划扩展至约100万GPU规模。据StorageReview报道,Meta工程师凯文·李、亚沙尔·巴亚尼、艾哈迈德·谢里夫与宋逸君在技术博客中详细披露了硬件配置、网络架构与可靠性数据。
剧集收视从传统数据中心到千兆瓦级AI枢纽
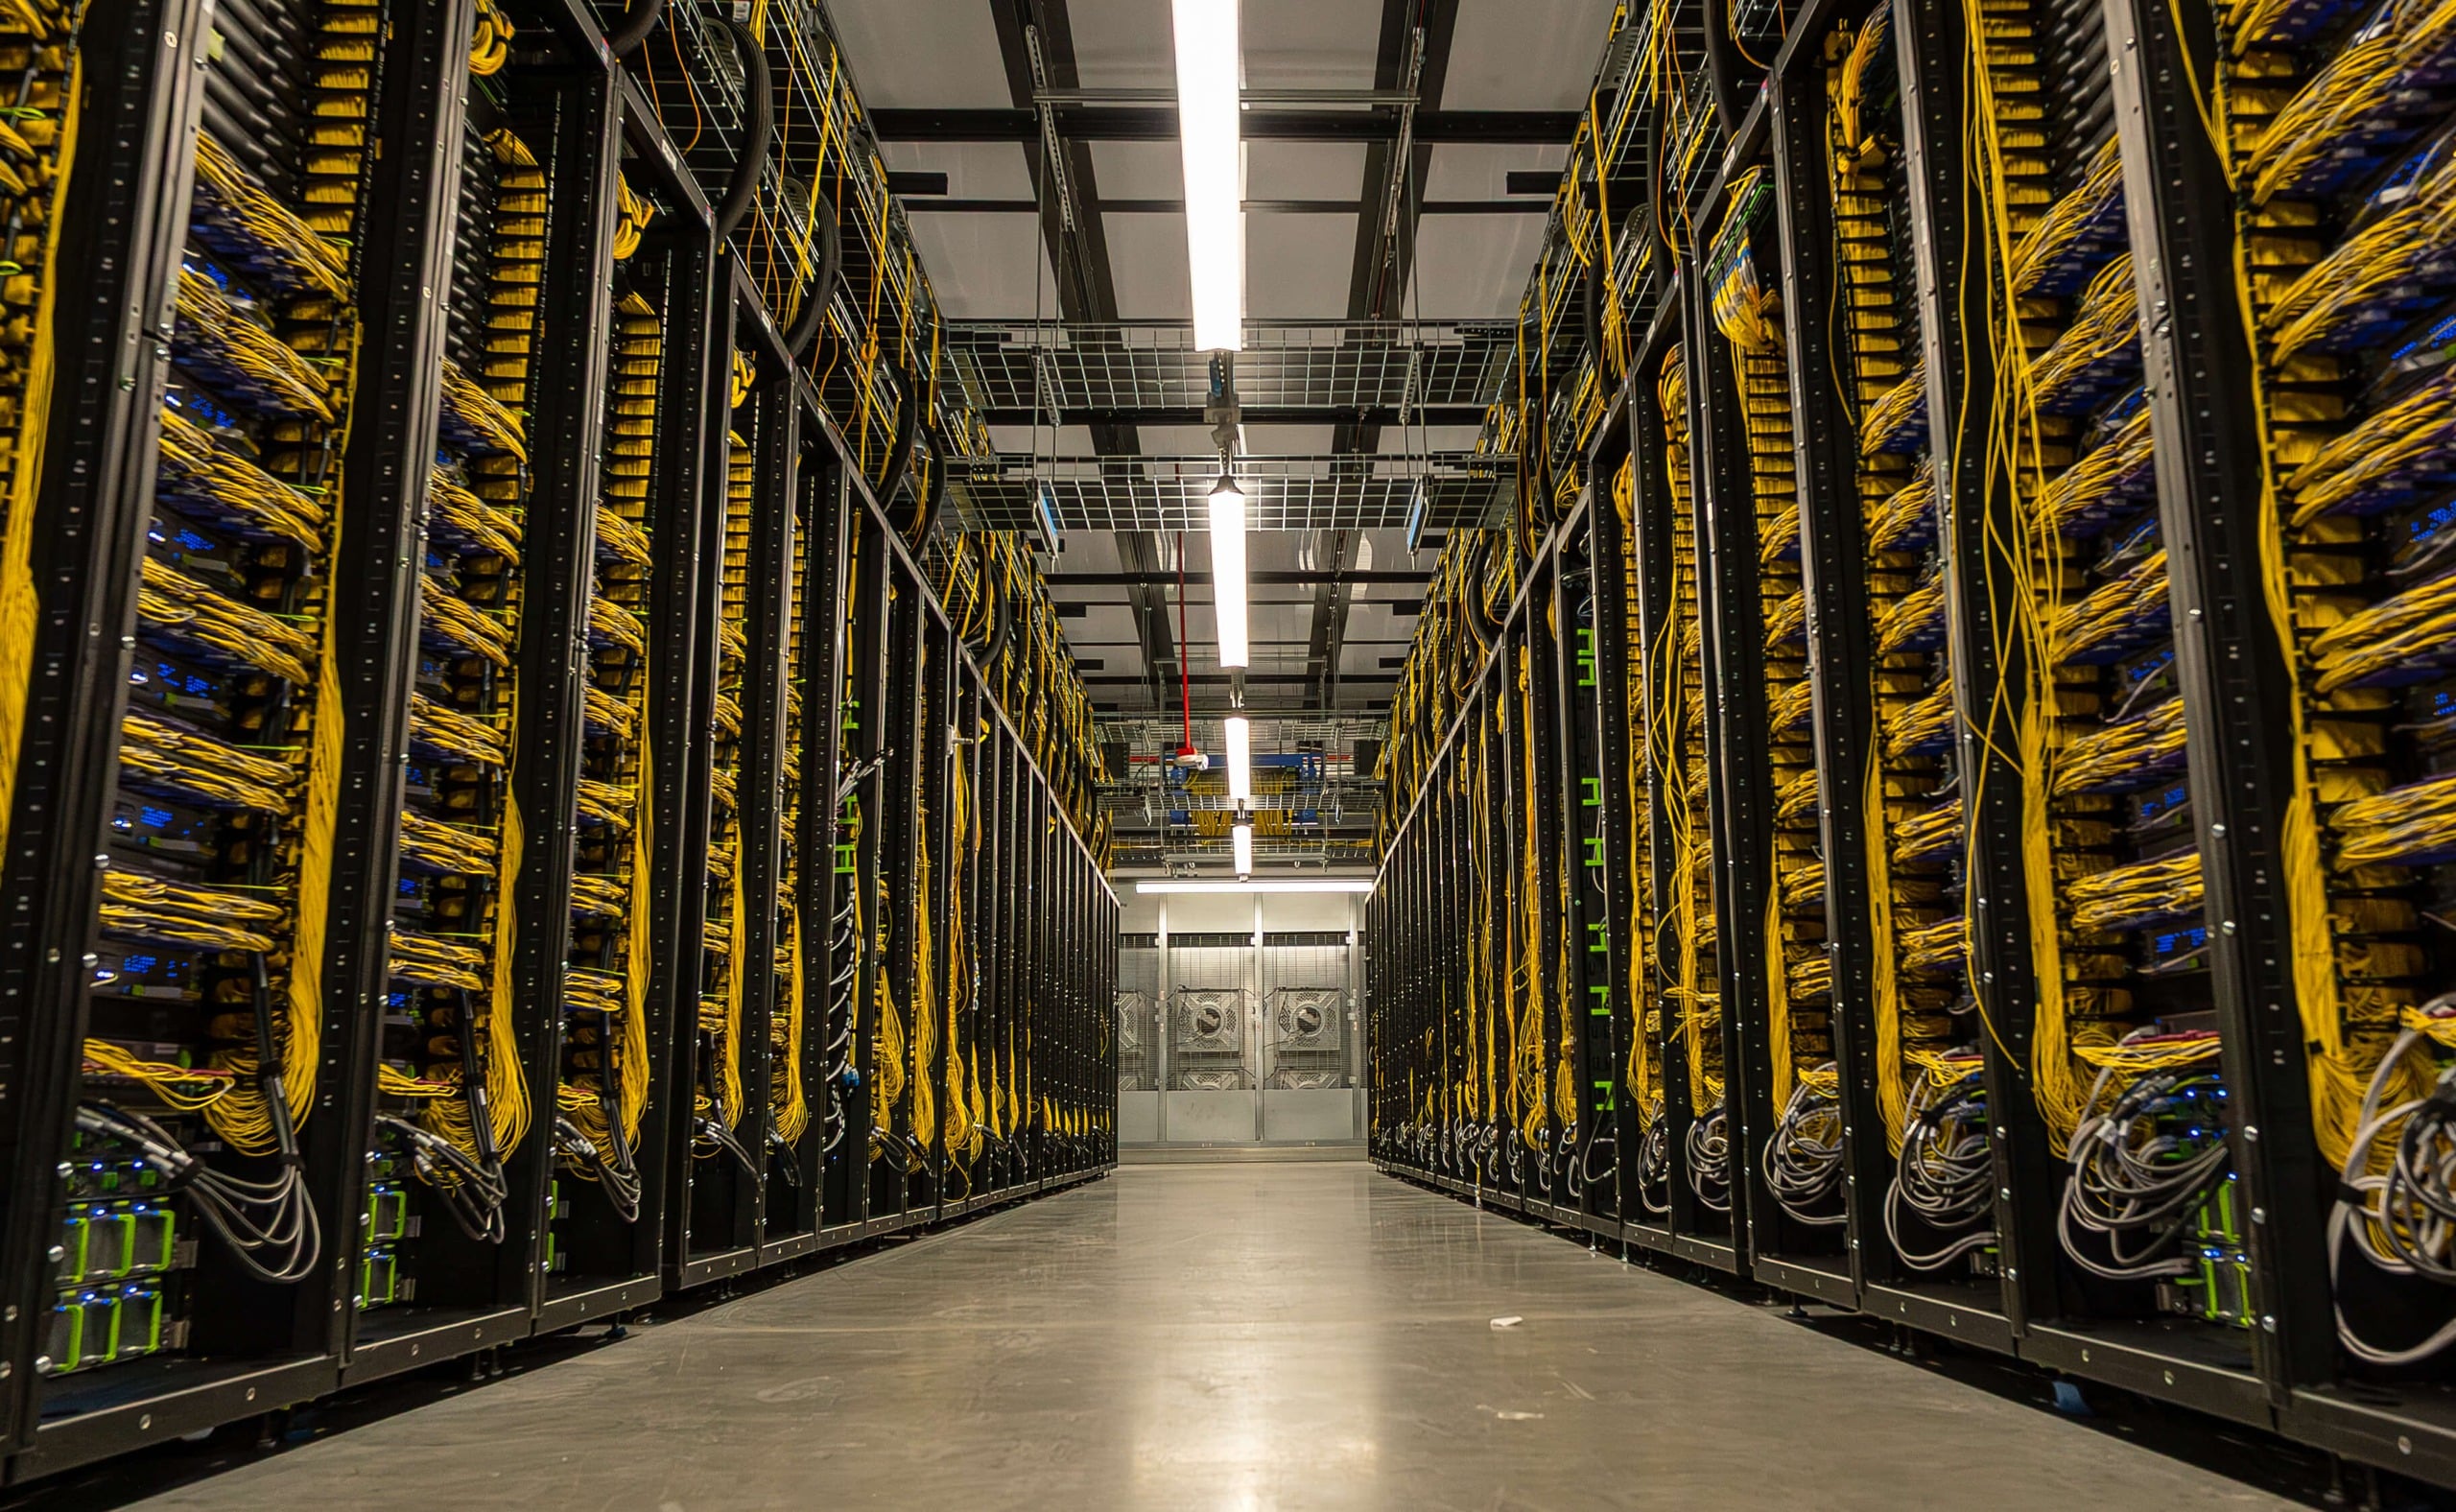
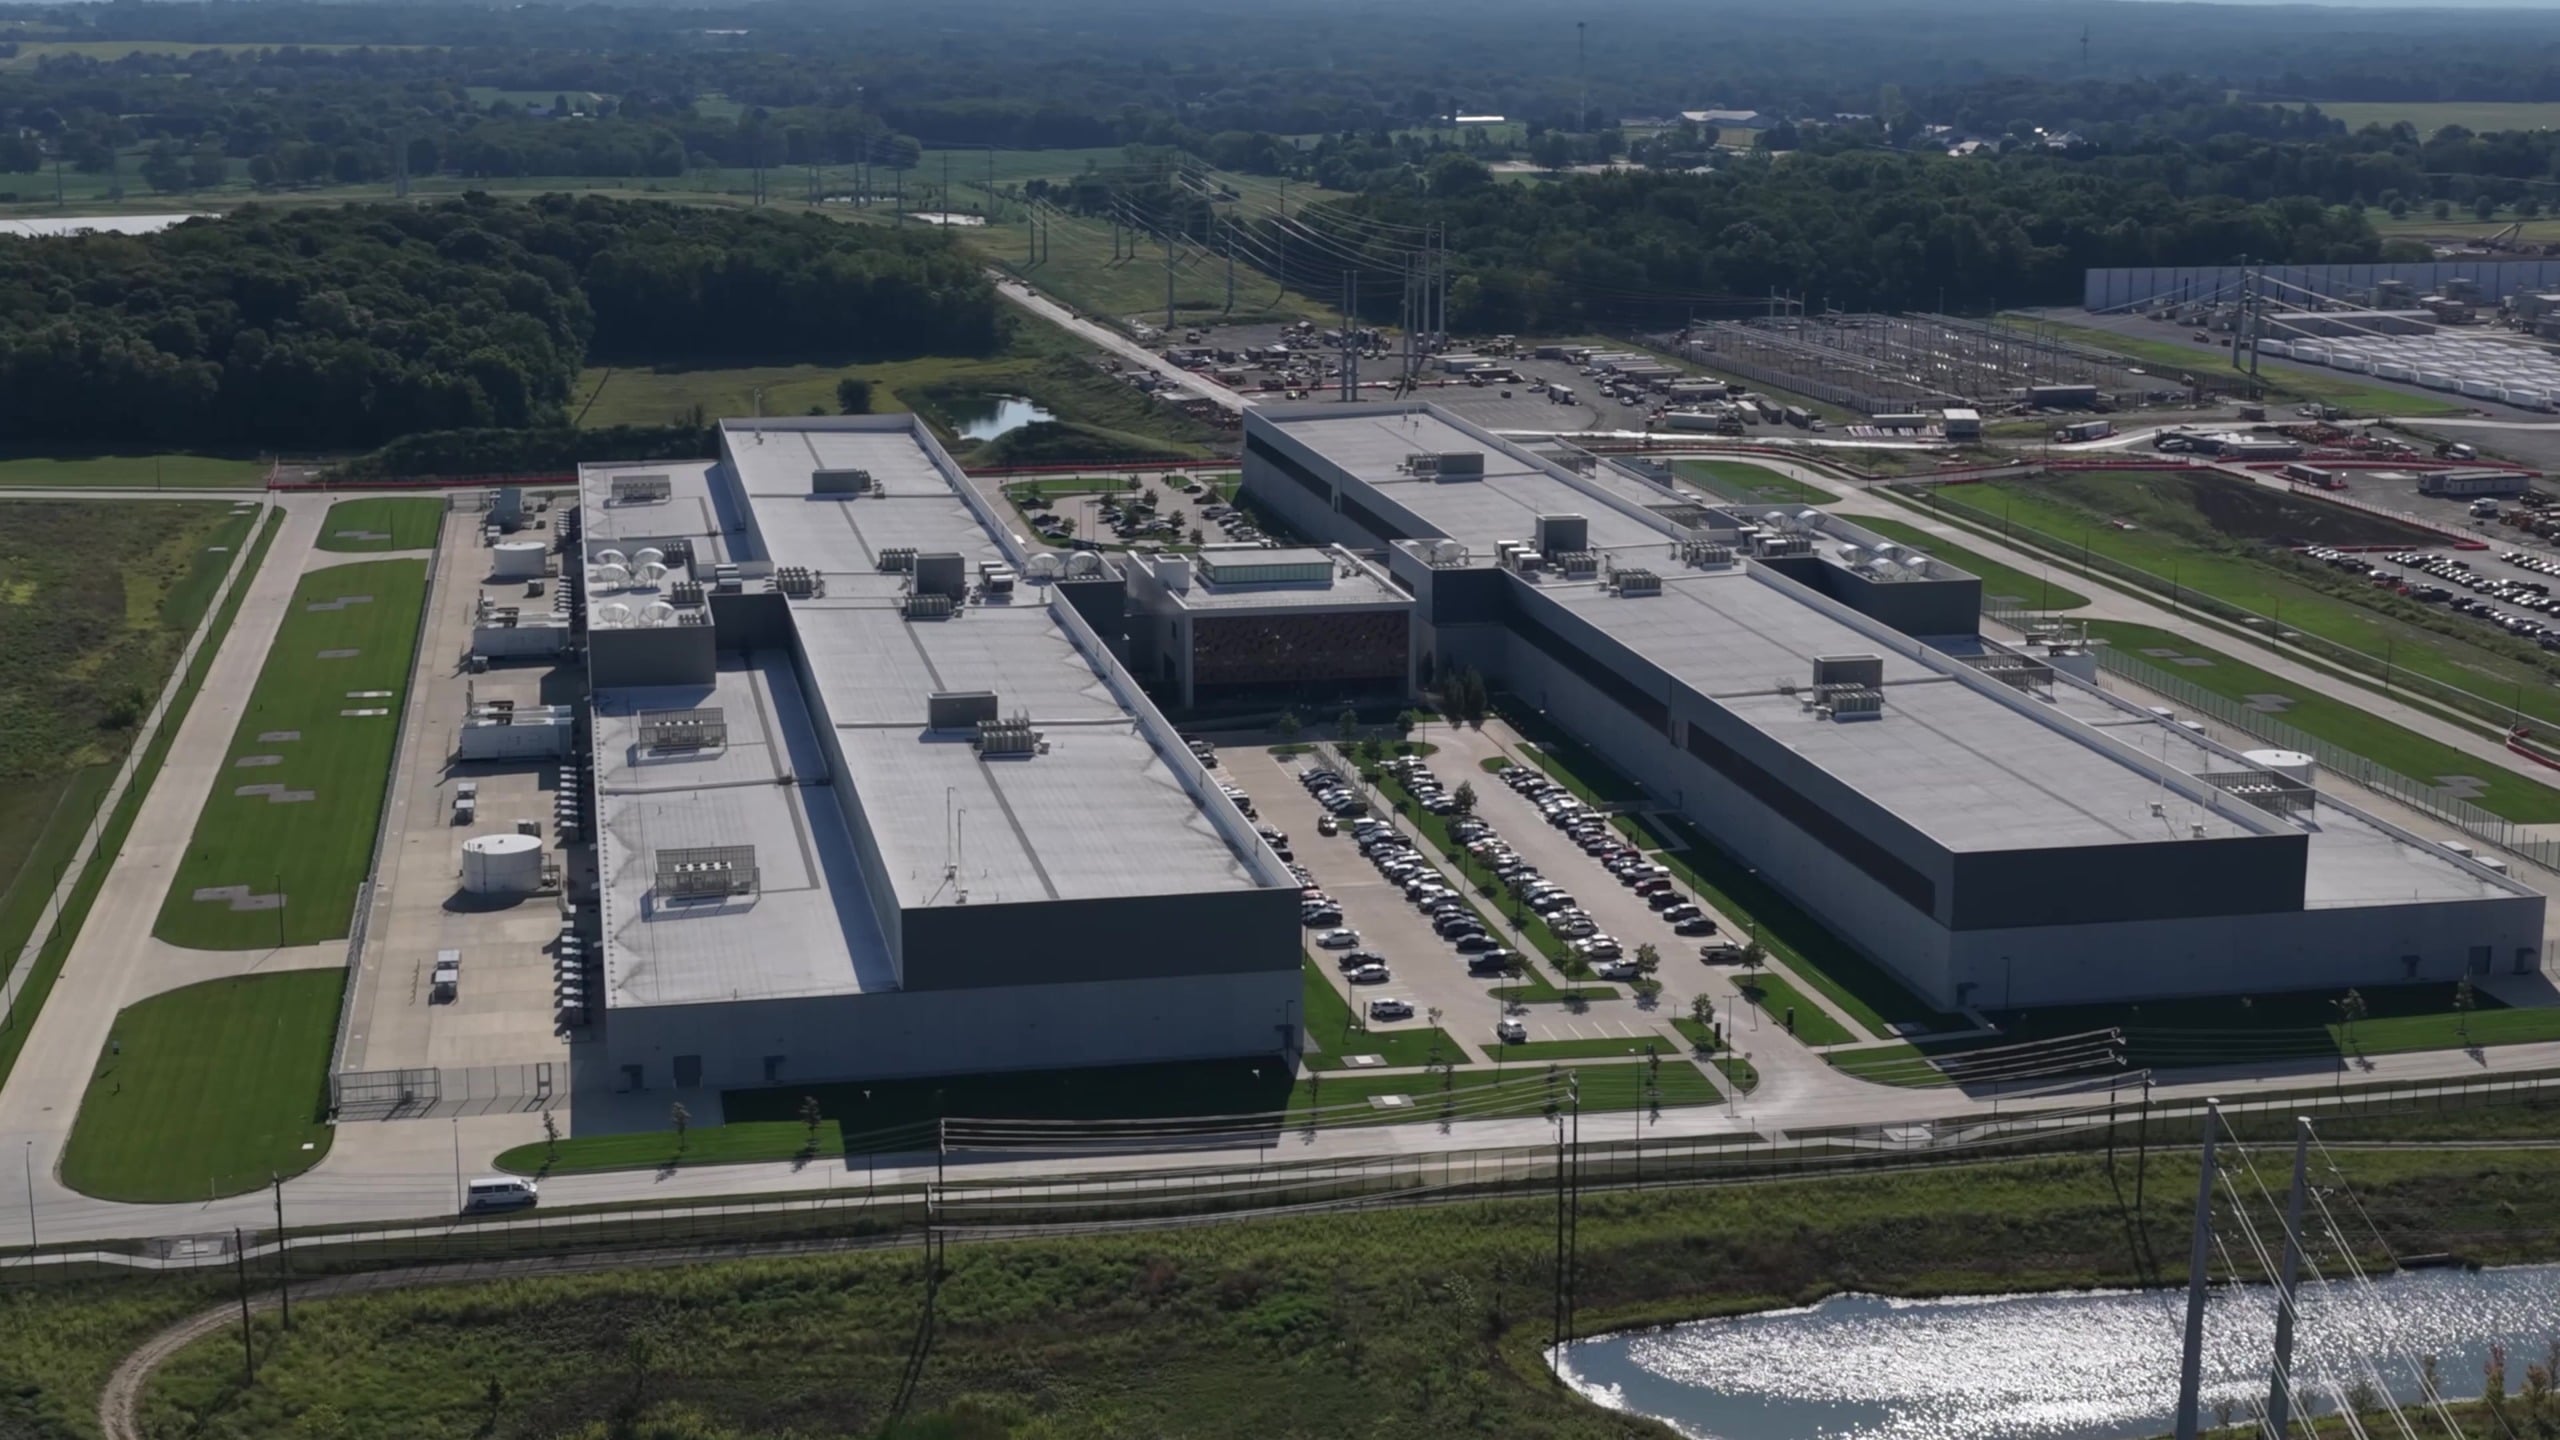
两年前,新奥尔巴尼园区还是一座处理Web流量的普通数据中心。Meta工程团队在博客中表示,园区如今的电力容量已跃升至千兆瓦级。“我们选择把Prometheus建在这里,是因为它具备即插即用的电力基础设施扩展空间,”工程师们写道。据StorageReview报道,该项目分阶段推进,第一阶段已成功完成Muse系列基础模型的训练,验证了从机架部署、液冷散热到大规模训练调度的整条供应链。园区内冷通道两侧整齐排列的黄色光纤线缆,揭示着这座超级集群的物理规模。
剧集口碑两代NVL72平台并行:Catalina与Clemente
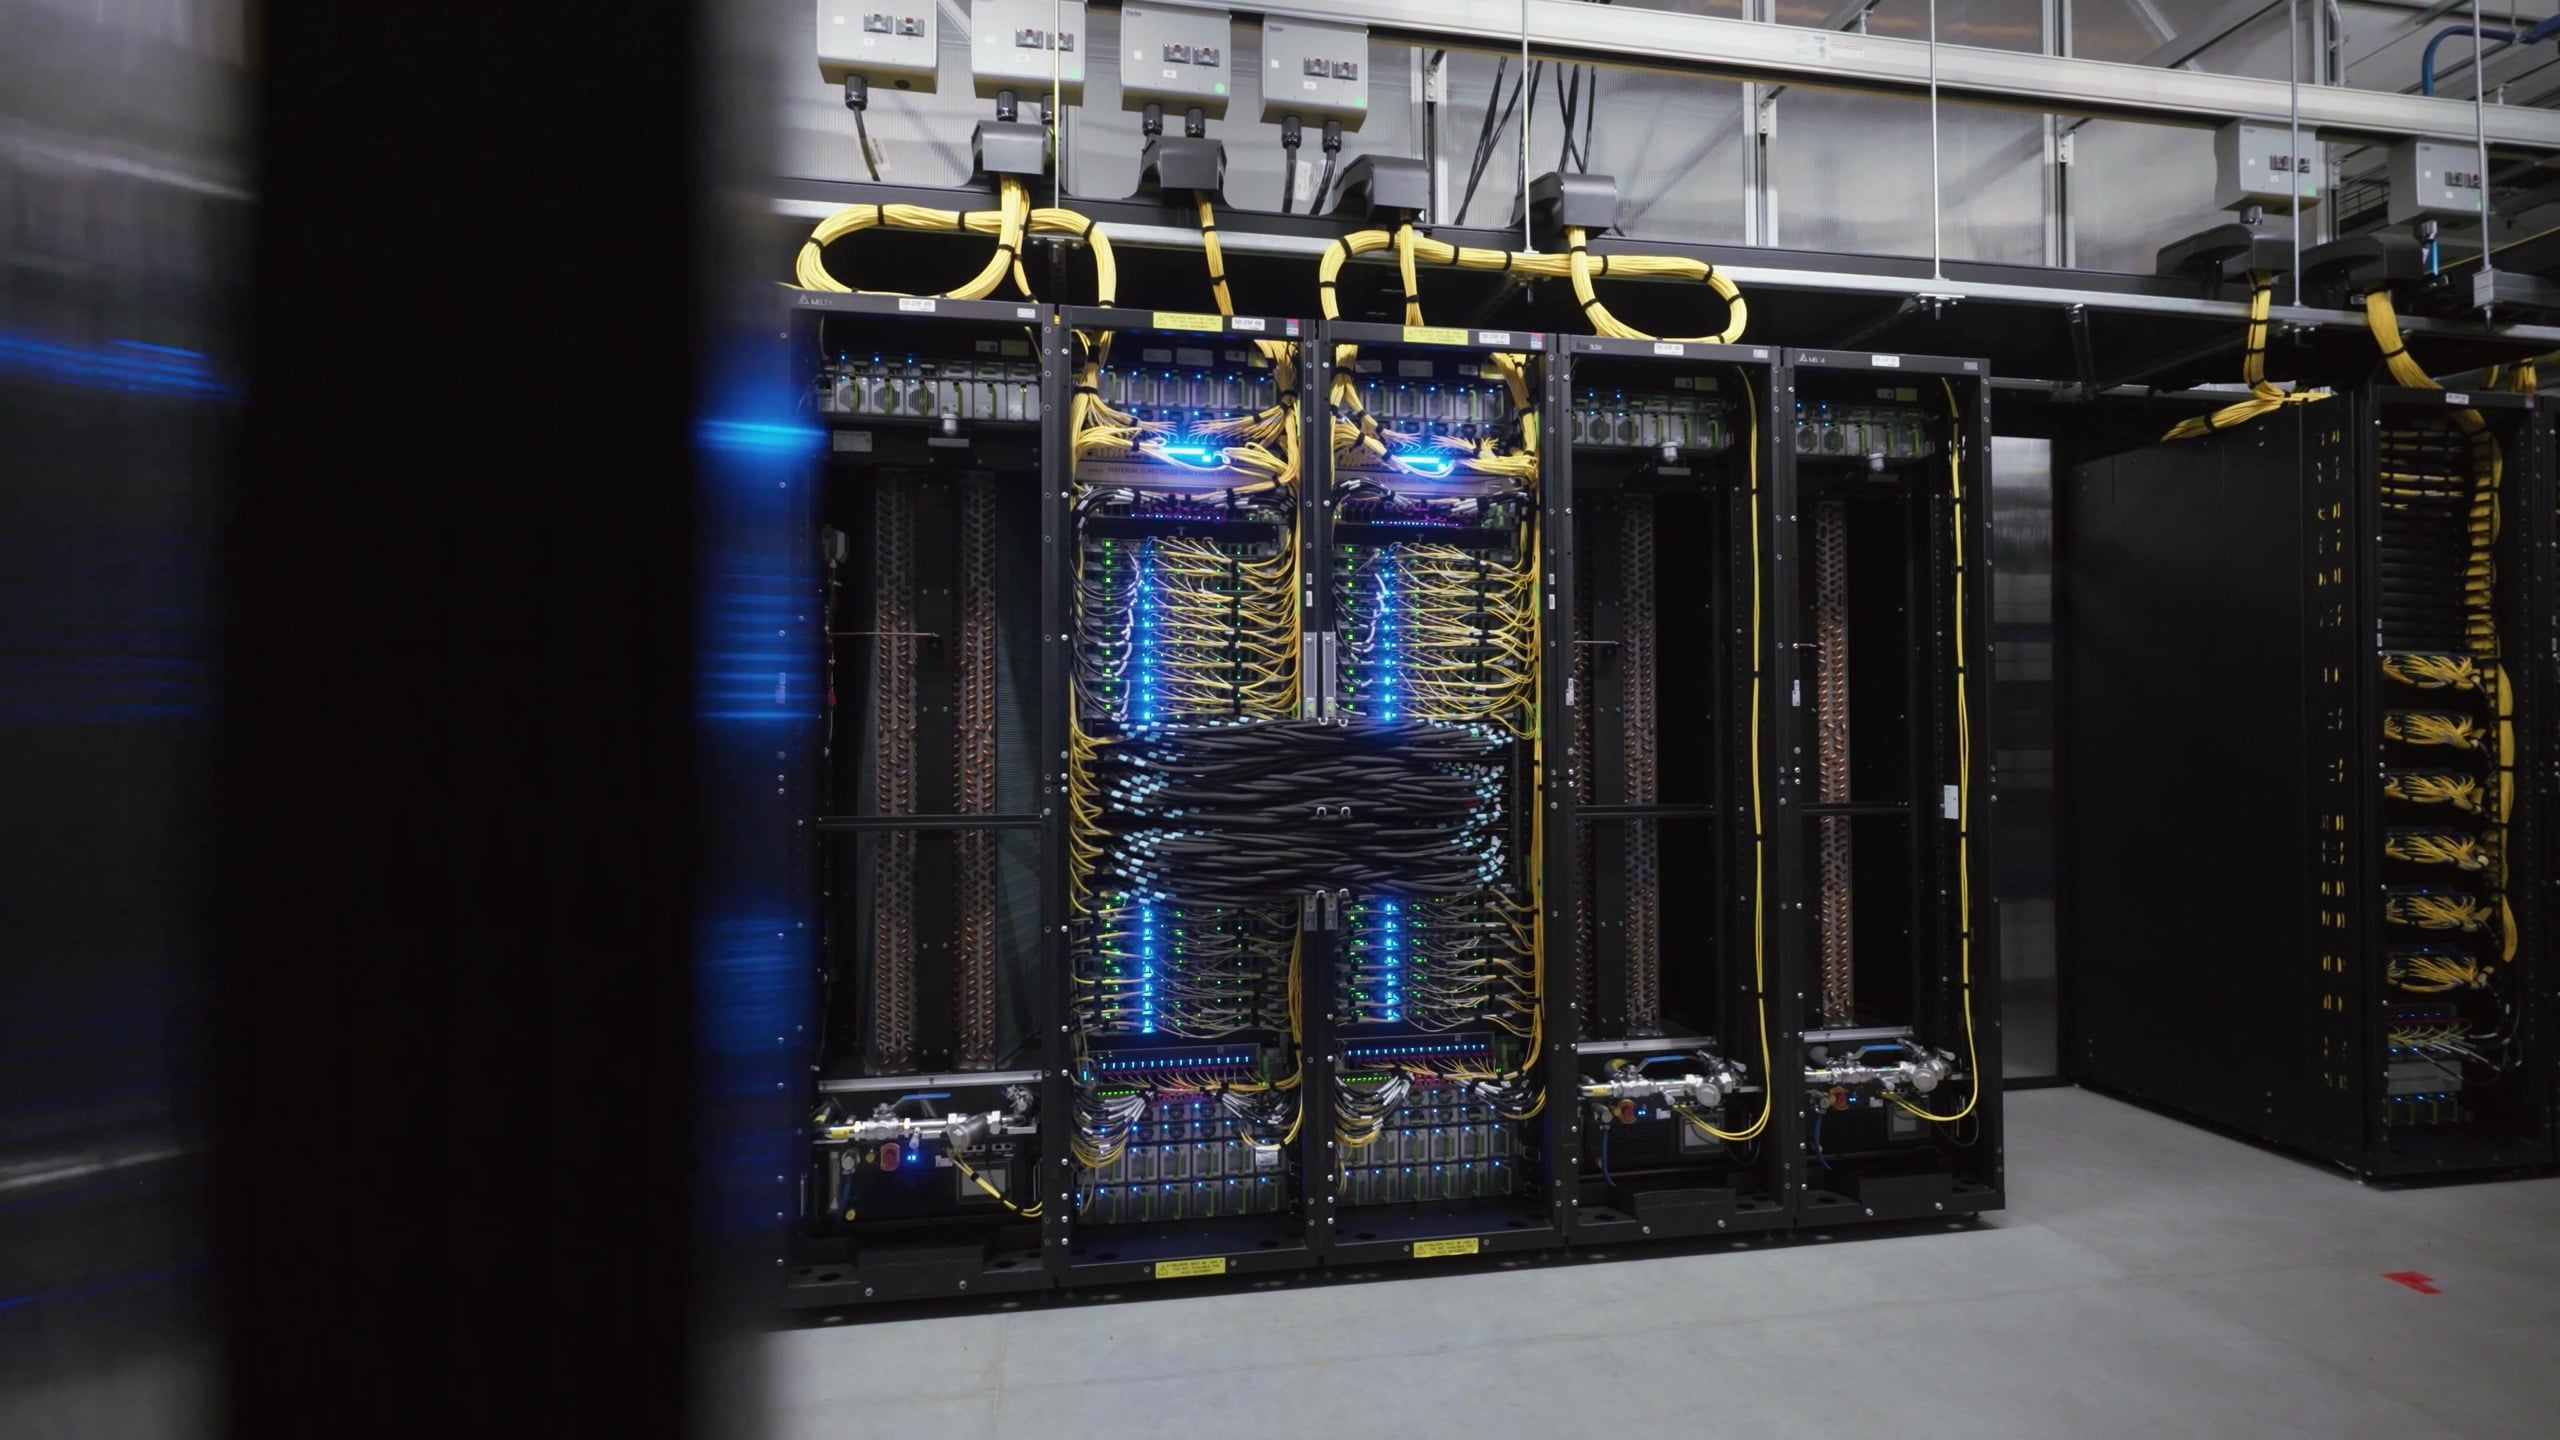
Prometheus目前运行两代NVIDIA GPU平台,均基于NVL72机架架构——72颗GPU共享一个NVLink域。Meta将首个平台命名为Catalina,采用GB200 NVL72的Ariel变体:双机架结构,每架36颗GPU,基于Meta为开放计算项目(OCP)贡献的Open Rack V3高功率机架设计。每颗Blackwell GPU搭配一颗Grace CPU和两张ConnectX-7 400G网卡,1:1的CPU与GPU配比使每颗GPU获得800G的横向扩展带宽。据Meta数据,单套Catalina双机架包含72颗Blackwell GPU,配备13.4TB HBM3e(每GPU 192GB),FP8峰值训练算力720 PFLOPS(FP4下达1,440 PFLOPS),域内NVLink带宽130TB/s,聚合内存带宽576TB/s,双机架功耗约120kW。
平台规格对比:两代机架的硬件演进
| 技术规格 | Catalina (GB200 NVL72) | Clemente (GB300 NVL72) |
|---|
| --- | --- | --- |
|---|
| 机架形态 | 双机架,36 GPU/架 | 单机架,72 GPU/架 |
|---|
| 每GPU HBM | 192GB HBM3e | 288GB HBM3e |
|---|
| 总HBM容量 | 13.4TB | 20.7TB |
|---|
| FP4峰值算力 | 1,440 PFLOPS | 超过1 exaFLOP |
|---|
| NVLink带宽 | 130TB/s(域内) | 130TB/s(域内) |
|---|
| 单架功耗 | 约120kW(双架) | 约135kW |
|---|
| 相对性能增益 | 基准 | 提升5%-10% |
|---|
第二平台Clemente转向GB300 NVL72后,每GPU HBM提升1.5倍至288GB,FP4稠密算力增幅相近,注意力加速器性能近乎翻倍。ConnectX-8 SuperNIC原生提供每GPU 800G带宽,GPU与CPU配比调整为2:1,完整72颗GPU域可容纳在单个机架内。Meta列出的数据显示,Clemente配备20.7TB HBM3e、FP4峰值算力超过1 exaFLOP、NVLink带宽130TB/s(每GPU双向1.8TB/s)、单机架功耗约135kW,整体性能较GB200 NVL72提升5%至10%。
San Miguel平台与Vera Rubin NVL72
Meta的下一代平台San Miguel将把Vera Rubin NVL72接入同一张网络织物。Meta披露的数据显示,该机架采用每GPU 288GB的HBM4(带宽19.2TB/s),FP4峰值训练算力2.52 exaFLOPS、FP8下单1.26 exaFLOPS,NVLink带宽216TB/s(每GPU 3TB/s),聚合内存带宽约1,500TB/s,计算托盘全液冷,单机架功耗超过170kW,每瓦性能较GB300 NVL72提升10%至20%。据StorageReview确认,CoreWeave已于2026年10月上旬率先将Vera Rubin NVL72投入生产,这意味着该平台的供应链已开始放量交付。
可靠性工程:MTBI从47,000到54,000 GPU小时
Meta公布的可靠性数据是本次披露的亮点。据StorageReview报道,Muse Wonder预训练任务的goodput(有效吞吐率)超过85%,强化学习任务超过90%。训练运行期间的时钟时间平均中断间隔(MTBI)约为47,000 GPU小时;此后推送的固件修复将MTBI推升至54,000 GPU小时以上。Meta设定的工程目标是每8,000颗GPU每天最多出现2次中断,换算后约为100,000 GPU小时的中断间隔。“固件层面的问题往往导致数十小时的宕机排查,”Meta工程师在博文中写道,“我们将超过一半的可靠性预算投入到GPU固件、NIC与交换机软件栈的联合调试中。”与Prometheus早期运行阶段相比,训练任务中断总次数下降99%,这些优化成果已直接体现在Muse系列模型的训练效率上。
跨建筑以太网专用后端架构
Prometheus的训练流量运行在一张独立于前端服务网络的第二数据中心网络上。Meta的设计遵循训练任务的拓扑特征:延迟敏感、带宽密集的集合通信在同一建筑织物内完成,而容忍度较高的副本间通信跨过聚合层在建筑间传输。每座建筑的织物最多连接20,736颗GPU。Meta将此分层结构依次应用于早期的24,000 GPU建筑级集群、100,000颗以上GPU的区域级集群,最终扩展至Prometheus。与英伟达推崇的InfiniBand方案不同,Meta坚持以太网路线——其自研的Disaggregated Scheduled Fabric采用子数据包多路径路由,在超大规模环境下具备更成熟的运维生态与成本优势。
常见问题
Q1: Prometheus超级集群的最终规模目标有多大?
A1: Meta计划将Prometheus扩展至约100万颗GPU。目前第一阶段已完成,基于GB200 NVL72(Catalina)与GB300 NVL72(Clemente)双平台训练了Muse系列基础模型,第三阶段San Miguel将引入Vera Rubin NVL72。
Q2: Meta如何实现训练中断率的大幅下降?
A2: 主要依靠固件与驱动栈迭代、专用以太网后端网络和硬件冗余设计。固件修复使MTBI从约47,000 GPU小时提升至54,000 GPU小时以上,Meta的工程目标是将每8,000颗GPU的日中断次数控制在2次以内,折算约100,000 GPU小时的中断间隔。
Prometheus的公开披露标志着Meta在超大规模AI基础设施竞赛中迈出关键一步。随着Catalina、Clemente与San Miguel三代平台的迭代,以及约100万GPU远景的铺开,这家科技巨头正试图以工程化的方式驯服AI算力扩张的物理极限。未来两年,新奥尔巴尼的数据中心将成为检验这条路径的试金石。